Warum die KI Ihre Artikelnummer nicht findet: pgvector, Azure AI Search und Co. verständlich verglichen
Eine Vektordatenbank sucht nach Bedeutung, nicht nach Zeichen. Für sie liegen "4711-B02" und "4711-B03" fast an derselben Stelle, deshalb landet die falsche Artikelnummer oben. Ein Wissenssystem braucht darum mehrere Suchen zugleich: nach Bedeutung, nach exaktem Wortlaut und nach Wortstämmen. Welches Produkt diese Suche liefert, ist zweitrangig. Entscheidend sind Datenstandort, Leserechte und wer den Betrieb übernimmt.
Drei Arten zu suchen
Wenn ein Wissenssystem "sucht", kann das drei verschiedene Dinge bedeuten. Jede findet etwas anderes.
| Suchart | So funktioniert sie | Findet gut | Findet schlecht |
|---|---|---|---|
| Nach Bedeutung | Text wird in eine Zahlenreihe übersetzt, ähnliche Bedeutung liegt nah beieinander | Umschreibungen, andere Sprache | Nummern, Namen, Daten |
| Nach Wortlaut | Vergleicht Zeichen und Wörter | "4711-B02", "DIN EN 1092-1" | Synonyme, Umschreibungen |
| Nach Wortstamm | Führt Wörter auf ihre Grundform zurück | "Dichtungen" findet "Dichtung" | Zusammengesetzte Fachbegriffe ohne Wörterbuch |
Die Suche nach Bedeutung nennt man auch semantische Suche oder Vektorsuche. Eine Vektordatenbank speichert genau diese Zahlenreihen und findet zu einer Frage die nächstgelegenen. Das ist eine große Hilfe, wenn Mitarbeitende anders formulieren als das Handbuch. Microsoft schreibt in der Dokumentation zu Azure AI Search selbst, dass Produktcodes, Fachjargon, Datumsangaben und Personennamen mit klassischer Stichwortsuche besser gefunden werden, weil sie exakte Treffer erkennt (Microsoft Learn, Hybrid Search).
Die Suche nach Wortstamm ist im Deutschen wichtiger als im Englischen. "Rückgabefrist", "Rückgabefristen" und "Frist für die Rückgabe" sollen dasselbe finden. PostgreSQL bringt dafür Wörterbücher für Deutsch und viele weitere Sprachen mit (PostgreSQL-Dokumentation).
Warum die Artikelnummer verschwindet
Ein Beispiel aus dem Großhandel. Eine Kollegin im Innendienst fragt: "Welche Lieferzeit hat 4711-B02?" Im Bestand gibt es Datenblätter zu 4711-B02, 4711-B03 und 4711-B20 sowie eine allgemeine Seite zu Lieferzeiten.
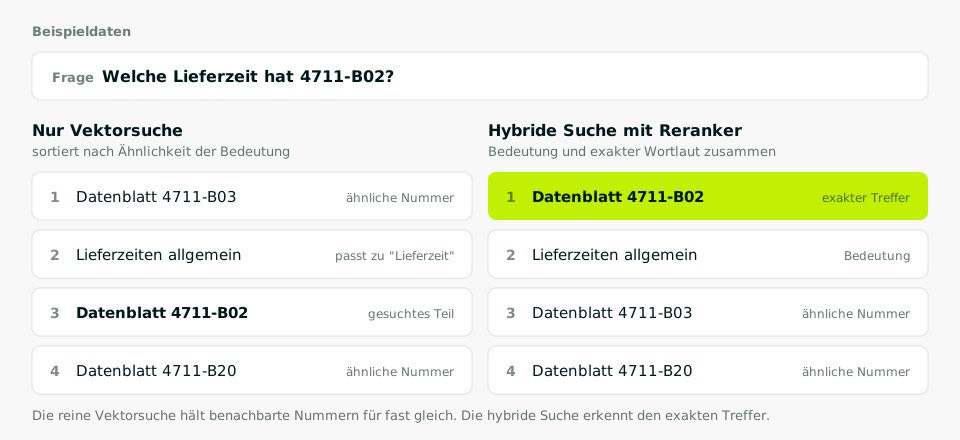
Die reine Vektorsuche liefert ähnliche Dokumente. Für die Vektorsuche sehen benachbarte Nummern fast gleich aus, und das Wort "Lieferzeit" passt am besten zur allgemeinen Seite. Das Datenblatt, um das es geht, steht auf Platz drei oder fehlt ganz. Das Sprachmodell antwortet dann flüssig, aber zur falschen Nummer.
Die hybride Suche schickt dieselbe Frage zweimal los, einmal nach Bedeutung und einmal nach Wortlaut, und legt beide Trefferlisten zusammen. Was in beiden weit oben steht, gewinnt. Azure AI Search und Elasticsearch nutzen dafür ein Verfahren namens Reciprocal Rank Fusion (Microsoft Learn, Elastic). Danach liest ein zweites, kleineres Modell die besten Treffer noch einmal zusammen mit der Frage und sortiert sie neu. Fachleute nennen es Reranker.
Die Optionen im Vergleich
Fünf Wege sind im Mittelstand üblich. Die Tabelle vergleicht sie nach den Punkten, die für ein Wissenssystem zählen.
| Ansatz | Hybride Suche | Leserechte | Betrieb und Standort |
|---|---|---|---|
| PostgreSQL mit pgvector | Vektor und Volltext in einer Datenbank, wird zusammengebaut | Setzt die Datenbank selbst durch | Ihr Haus oder deutsches Rechenzentrum |
| Azure AI Search | Eingebaut, Ranker als Zusatzfunktion | Filter allgemein verfügbar, SharePoint-Rechte in Vorschau | Verwalteter Dienst in einer Azure-Region |
| Elasticsearch, OpenSearch | Eingebaut | Über Filter oder Rechte im Produkt | Eigener Cluster oder Cloud |
| Qdrant, Weaviate, Pinecone | Eingebaut | Rechte als Metadaten mitführen und filtern | Qdrant und Weaviate auch selbst betrieben, Pinecone vor allem Cloud |
| Copilot mit SharePoint | Übernimmt Microsoft | Aus den Rechten in Microsoft 365 | Microsoft 365, Lizenz je Nutzer |
Ein paar Anmerkungen zu den Zeilen:
PostgreSQL mit pgvector. pgvector ist eine Erweiterung für PostgreSQL, keine eigene Datenbank. Vektoren liegen neben Text, Metadaten und Rechten in denselben Tabellen (pgvector). Die hybride Suche ist nicht fertig eingebaut, sondern wird aus Vektorsuche und Volltextsuche zusammengesetzt. Dafür ist alles in einem System, und Leserechte lassen sich mit Row-Level Security in der Datenbank durchsetzen.
Azure AI Search. Volltext und Vektor laufen in einer Abfrage. Leserechte aus SharePoint zu übernehmen ist laut Microsoft noch Vorschau; der SharePoint-Indexer selbst ebenfalls (Microsoft Learn, Dokumentrechte, SharePoint-Indexer). Zu den Kosten: Abgerechnet wird nach gebuchter Stufe und Stunde, von einer kostenlosen Stufe mit 50 MB Speicher über Basic mit 15 GB bis zu den Standard-Stufen. Zusatzfunktionen wie der semantische Ranker kosten extra, eine Serverless-Variante ist in Vorschau (Azure-Preisseite, Stand Oktober 2026). Die Kosten wachsen also mit der Stufe, nicht mit jeder einzelnen Frage.
Elasticsearch oder OpenSearch. Beide verbinden klassische Volltextsuche mit Vektorsuche (OpenSearch). Das lohnt sich vor allem dort, wo schon ein Cluster läuft und jemand ihn betreut.
Qdrant, Weaviate oder Pinecone. Spezialisierte Vektordatenbanken, alle mit hybrider Suche (Qdrant, Weaviate, Pinecone). Sie sind ein weiteres System neben Ihren Daten. Leserechte und Versionen müssen als Metadaten mitgeführt und aktuell gehalten werden.
Copilot mit SharePoint. Kein eigenes Projekt, sondern ein Standardprodukt. Copilot sucht in dem, was die Person in Microsoft 365 lesen darf (Microsoft Learn). Quellen außerhalb von Microsoft 365 brauchen Konnektoren (Microsoft Learn, Copilot-Konnektoren).
Drei Fragen statt Benchmark
Bei den Mengen, die in Handbüchern, Richtlinien und Vorgängen eines Mittelständlers zusammenkommen, sind alle genannten Produkte schnell genug. Ob die Suche ein paar Millisekunden schneller ist, merkt niemand, der auf eine Antwort wartet; die meiste Zeit braucht das Sprachmodell zum Formulieren. Die Entscheidung fällt anderswo.
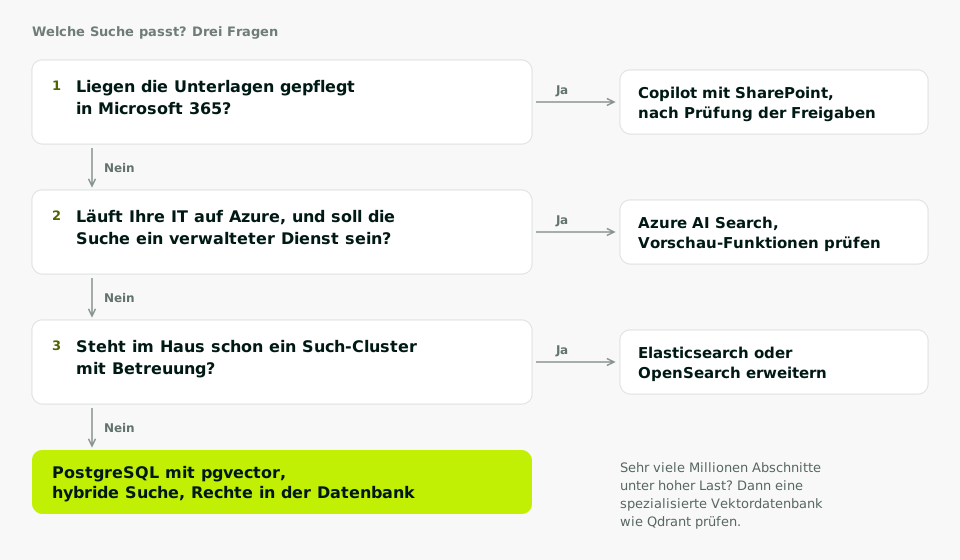
- Liegen die Unterlagen gepflegt in Microsoft 365? Dann zuerst Copilot testen, nachdem die Freigaben geprüft sind. Ein eigenes Projekt brauchen Sie dann vielleicht gar nicht.
- Läuft Ihre IT ohnehin auf Azure, und soll die Suche ein verwalteter Dienst sein? Dann ist Azure AI Search naheliegend. Prüfen Sie vorher, welche Rechte-Funktionen Sie brauchen und ob sie noch Vorschau sind.
- Steht im Haus schon ein Such-Cluster mit Betreuung? Dann erweitern Sie ihn. Sonst ist PostgreSQL mit pgvector der einfachste Weg.
Microsoft empfiehlt in seinem eigenen Architekturleitfaden ähnlich: Wer bereits eine Datenbank mit Vektorsuche betreibt und auf Kosten achtet, nutzt diese (Microsoft Learn, Vektorsuche in Azure).
Warum PostgreSQL mit pgvector unser Standard ist
Wir bauen Wissenssysteme auf PostgreSQL mit pgvector, in Deutschland betrieben. Gesucht wird dreifach: nach Bedeutung, nach exaktem Wortlaut für Artikelnummern und Namen und nach Wortstämmen auf Deutsch und Englisch. Ein selbst betriebener Reranker sortiert die Treffer, und jede Antwort nennt Kapitel und Seite.
Der eigentliche Grund ist nicht Geschwindigkeit, sondern dass Text, Version und Leserecht in derselben Datenbank liegen. Wer ein Dokument nicht lesen darf, bekommt es nicht als Treffer, weil die Datenbank die Zeile gar nicht herausgibt. Bei einer separaten Vektordatenbank müssten diese Rechte doppelt gepflegt und synchron gehalten werden.
Die Grenzen nennen wir auch: Bei sehr großen Mengen, etwa vielen Millionen Abschnitten mit hoher Last, braucht der Index viel Arbeitsspeicher, und eine spezialisierte Lösung kann günstiger sein. Und wer seine Daten sauber in Microsoft 365 hat, ist mit Copilot oft schneller am Ziel.
Ihr nächster Schritt
Schreiben Sie zwanzig echte Suchanfragen aus Ihrem Alltag auf, darunter mindestens fünf mit Artikelnummern, Normen oder Kundennamen, und notieren Sie zu jeder das Dokument, das gefunden werden soll. Mit dieser Liste lässt sich jede der Optionen in wenigen Tagen ehrlich prüfen. Wie wir das angehen, steht auf der Seite KI-Wissenssysteme. Ein typischer Fall mit Teilenummern ist die Ersatzteil-Erkennung.