ChatGPT mit eigenen Daten füttern? Was ein Wissenssystem anders macht
Sie müssen ChatGPT nicht mit Ihren Daten trainieren, und in den meisten Fällen sollten Sie es auch nicht. Was Sie eigentlich wollen, ist ein System, das bei jeder Frage in Ihren freigegebenen Unterlagen nachschlägt, nur daraus antwortet und dazu sagt, wo es steht. Fachleute nennen das Retrieval-Augmented Generation, kurz RAG. Wir nennen es ein Wissenssystem.
Warum "trainieren" das falsche Bild ist
Ein Sprachmodell wie das hinter ChatGPT hat aus sehr großen Textmengen gelernt, wie Sprache funktioniert und was in diesen Texten häufig zusammen vorkam. Dieses Wissen steckt verteilt in Milliarden Zahlen. Es gibt darin keinen Ordner "Handbuch VX-400" und keinen Verweis darauf, woher eine Aussage stammt.
Wer ein Modell mit eigenen Dokumenten nachtrainiert (Fine-Tuning), ändert vor allem, wie es antwortet. OpenAI nennt als Zwecke für Fine-Tuning zum Beispiel ein festes Antwortformat oder eine bestimmte Aufgabe, die ein kleineres Modell zuverlässig erledigen soll (OpenAI, Model optimization). Ein Nachschlagewerk für Ihr Unternehmen wird daraus nicht. Drei Gründe:
- Keine Fundstelle. Das Modell kann nicht sagen, aus welchem Dokument eine Aussage kommt. Ob sie stimmt, prüft niemand in Sekunden.
- Veraltet ab dem nächsten Tag. Jede neue Version einer Richtlinie hieße: neu trainieren. Die alte Fassung steckt trotzdem noch im Modell.
- Keine Leserechte. Was einmal im Modell steckt, kann jede Person herausfragen, die das Modell nutzt. Einem Modell lässt sich nicht beibringen, dass der Service den Rahmenvertrag des Vertriebs nicht sehen darf. Und ein einzelnes Dokument lässt sich nicht gezielt wieder herausnehmen, etwa wenn jemand nach Art. 17 DSGVO die Löschung seiner Daten verlangt.
Was ein Wissenssystem stattdessen tut
Ein besseres Bild ist die Prüfung mit offenem Buch. Das Modell muss Ihre Unterlagen nicht auswendig kennen. Es muss die richtige Stelle finden, lesen und daraus eine Antwort formulieren. Der Ablauf hat vier Schritte:
- Quellen freigeben. Sie legen fest, welche Ablagen gelten: Handbücher, Arbeitsanweisungen, Vorgänge aus dem Ticketsystem. Diese werden in Abschnitte zerlegt. Jeder Abschnitt behält Dokument, Seite, Version und die Leserechte aus der Quelle.
- Suchen. Bei einer Frage sucht das System nur in den Abschnitten, die die fragende Person lesen darf. Gesucht wird nach Bedeutung und nach exaktem Wortlaut, damit auch Artikelnummern und Namen gefunden werden.
- Antworten. Das Sprachmodell bekommt die Frage und die gefundenen Abschnitte, nicht Ihr ganzes Archiv. Es antwortet nur daraus und nennt an jeder Aussage die Fundstelle.
- Ablehnen. Findet es nichts Belastbares, sagt es das, statt etwas Plausibles zu formulieren.
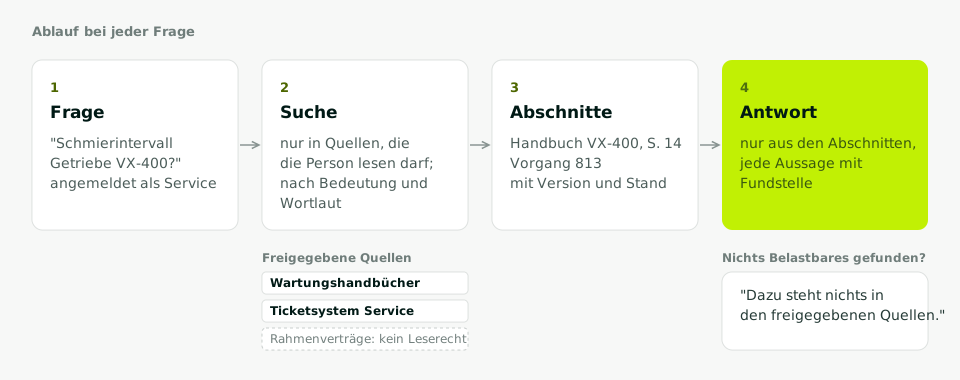
Der vierte Schritt ist der wichtigste. Ein Wissenssystem ist nur so gut wie seine Ablehnungen. "Dazu steht nichts in den freigegebenen Unterlagen" ist eine gute Antwort, weil sie zeigt, wo eine Lücke in der Dokumentation ist.
Dieselbe Frage, zwei Antworten
Ein Beispiel, so wie es in einem Maschinenbaubetrieb vorkommen könnte. Ein Servicetechniker fragt: "Wie oft muss das Getriebeöl bei der Baureihe VX-400 gewechselt werden?"
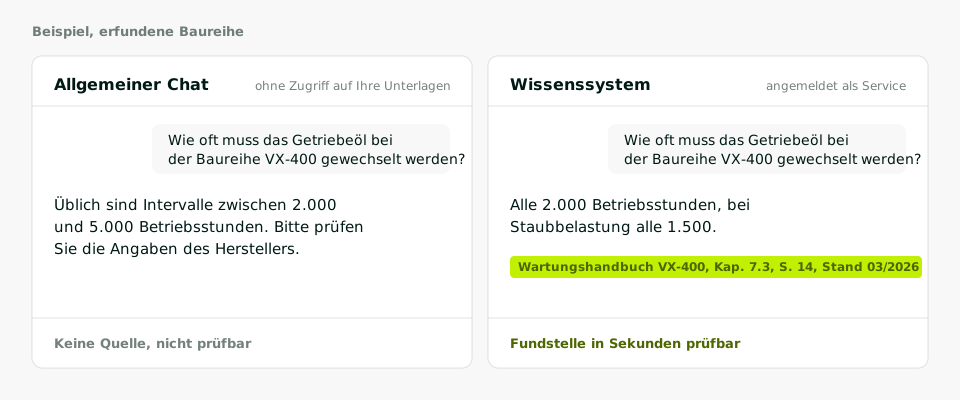
Der allgemeine Chat kennt die Baureihe nicht. Er antwortet mit einer üblichen Spanne und dem Rat, die Herstellerangaben zu prüfen. Das ist nicht falsch, hilft aber nicht. Das Wissenssystem nennt den Wert aus Ihrem Handbuch, die Ausnahme bei Staubbelastung und die Stelle, an der beides steht. Wer zweifelt, ist mit einem Klick auf Seite 14.
Reicht nicht ein Standardprodukt?
Manchmal ja. Die großen Anbieter gehen in dieselbe Richtung. ChatGPT Business und Enterprise können über verbundene Apps im Unternehmenswissen suchen und Quellen nennen (OpenAI Hilfe-Center). Microsoft Copilot antwortet aus Inhalten in Microsoft 365, auf die die Person mindestens Leserechte hat (Microsoft Learn).
Ein Standardprodukt passt, wenn Ihre Unterlagen gepflegt in SharePoint und Teams liegen und die Freigaben dort stimmen. Ein eigenes Wissenssystem lohnt sich eher, wenn:
- wichtige Quellen außerhalb von Microsoft 365 liegen, etwa im ERP, in einem Ticketsystem oder auf einem Laufwerk;
- Sie festlegen wollen, wo Daten und Modell laufen, bis hin zur "lokalen KI" im eigenen Rechenzentrum;
- die Antwort immer Kapitel und Seite nennen und bei fehlender Quelle ablehnen soll;
- Sie die Qualität an einem eigenen Satz echter Fragen messen wollen, bei jeder Änderung neu.
In beiden Fällen gilt: Zu weit gefasste Freigaben werden durch KI sichtbar. Warum das so ist und was Sie vorher aufräumen, steht in unserem Beitrag Wer darf was sehen?.
Was ein Wissenssystem braucht
Gepflegte Quellen. Entscheidend ist nicht die Menge, sondern ob jemand die Unterlagen pflegt. Liegen zwei Versionen einer Richtlinie nebeneinander, bekommt man die falsche Antwort, jetzt mit Beleg. Deshalb gehört zu jeder Quelle eine zuständige Person, und Altstände bleiben draußen. Liegen die Unterlagen als Scans vor oder doppelt, beginnt die Arbeit bei der Aufbereitung von Daten und Dokumenten.
Leserechte aus der Quelle. Das System sucht nur in dem, was die fragende Person ohnehin lesen darf, und filtert vor der Antwort, nicht danach. Fehlende Zugriffskontrolle im Suchindex führt die OWASP als eigenes Risiko für KI-Anwendungen (OWASP LLM08:2025). An diesem Punkt scheitern die meisten schnell gebauten Chatbots.
Aktualisierung ohne zweite Ablage. Ändert sich ein Dokument, läuft der Index nach, ersetzte Versionen fallen heraus, und die Antwort nennt den Stand. Niemand muss Inhalte in ein zweites System kopieren.
Ein Ort für die Daten. Vor dem ersten Dokument steht der Auftragsverarbeitungsvertrag nach Art. 28 DSGVO. Wir bauen Wissenssysteme auf PostgreSQL mit pgvector, in Deutschland betrieben, und nutzen Sprachmodelle über EU-Endpunkte, etwa von Mistral, IONOS, STACKIT, OVHcloud oder aus Ihrem eigenen Azure. Ein Modell, das im eigenen Haus läuft, ist möglich; dann liegt aber auch der Betrieb dort.
Ein Prüfsatz. Rund fünfzig echte Fragen mit bekannten Antworten und Fundstellen, von Ihrem Fachbereich bestätigt. Er wird bei jeder Änderung neu durchgerechnet. Ein "steht nicht drin" bei einer Frage ohne Quelle zählt dabei als Erfolg.
Was es kostet, in Phasen
Der Aufwand hängt von der Zahl und dem Zustand der Quellen, der Tiefe der Anbindung und den Anforderungen an Rechte und Nachvollziehbarkeit ab. Deshalb bauen wir in drei Phasen, und jede hat einen Preis, der vor dem Start feststeht:
| Phase | Was passiert | Ergebnis | Preis |
|---|---|---|---|
| KI-Strategie | Workshop an echten Vorgängen, Quellen sichten | Roadmap mit Aufwand und Nutzen | Festpreis |
| Pilot & Umsetzung | Ein Anwendungsfall, Abnahmekriterien vorab | Laufendes System mit Prüfsatz | Festpreis je Fall |
| Betrieb | Index, Updates, Messung | Stabil und gemessen | Jahresanteil vom Projektpreis |
Die aktuellen Preise stehen auf den verlinkten Seiten. Dazu kommen laufende Kosten für Hosting und die Nutzung des Sprachmodells, die mit der Zahl der Fragen wachsen. Beides nennen wir, bevor Sie sich entscheiden. Wer seinen ersten Anwendungsfall und die Quellen schon kennt, kann die erste Phase überspringen.
Ihr nächster Schritt
Sammeln Sie zwanzig Fragen, die in Ihrem Haus jede Woche gestellt werden, und schreiben Sie zu jeder dazu, in welchem Dokument die Antwort steht und wer es lesen darf. Fehlt bei vielen Fragen das Dokument, liegt das Wissen in Köpfen; dann hilft zuerst Aufschreiben, nicht KI. Steht es in gepflegten Unterlagen, ist das ein guter Kandidat für ein KI-Wissenssystem. Wie das im Service aussieht, zeigt der KI-Service-Assistent für Techniker.